Ngày 15/09/2026, TypeSafe AI mở truy cập sớm cho Jev, mô hình đầu tiên mà họ gọi là "System One". Người sáng lập là Diogo Almeida, cựu nghiên cứu viên OpenAI; theo The Register, ông là đồng phát minh RLHF và tham gia phát triển ChatGPT. Công ty ra khỏi giai đoạn hoạt động kín sau hai năm, với 40 triệu USD vốn đầu tư.
Câu hỏi mà Almeida đặt ra đáng để dừng lại: mô hình giỏi hơn người ở việc trò chuyện đã nhiều năm, vậy tự động hóa ở đâu? Phần lớn phần mềm doanh nghiệp không cần một câu trả lời hay. Nó cần một quyết định mà dòng lệnh tiếp theo dùng được ngay.
Jev khác gì một LLM
Jev không sinh chuỗi văn bản. Nó nhận trạng thái đầu vào và trả về quyết định có kiểu dữ liệu xác định (typed decisions): giá trị thuộc kiểu khai báo sẵn, kèm xác suất cho từng lựa chọn. Kiến trúc dùng bộ lấy mẫu song song, sinh toàn bộ đầu ra trong một truy vấn thay vì lần lượt từng token. Cách huấn luyện được hãng gọi là Reinforcement Learning for Calibrated Decisions, tối ưu cho xác suất trung thực thay vì cho việc chiều ý người đọc.
TypeSafe mô tả sản phẩm của họ gọn trong một câu: hãy coi Jev như một lời gọi hàm có trí tuệ tuyến đầu — trạng thái chưa cấu trúc đi vào, quyết định có kiểu dữ liệu xác định kèm xác suất đi ra.
Khác biệt thấy rõ nhất khi đặt cạnh nhau. Hỏi một LLM "khách hàng này có khả năng rời bỏ không", bạn nhận về một đoạn văn bắt đầu bằng "dựa trên thông tin hiện có, tôi cho rằng…" và phải tự bóc tách. Còn đầu ra của mô hình quyết định có dạng dùng được ngay:
{
  "churn_level": "HIGH",
  "probability": 0.87
}
Vì lược đồ được khai báo trước, ứng dụng dùng thẳng kết quả để rẽ nhánh, định tuyến, chấm điểm hay trích trường, không cần một lớp bóc tách văn bản ở giữa.
Ví dụ khác do The Register mô tả: phân loại một yêu cầu của khách hàng về đúng bộ phận, kèm phần trăm tin cậy cho mỗi hướng. Hãng còn cho Jev chơi Doom từ dữ liệu trạng thái game để chứng minh mô hình điều khiển được hệ thống thời gian thực.
Nguồn: TypeSafe AI — Introducing System One Models & Jev · The Register · AI News
Những con số hãng công bố
- Thời gian phản hồi 70–500 mili giây, mà hãng so là nhanh hơn 40–200 lần so với LLM tuyến đầu. Trong bản demo The Register dẫn lại: 0,114 giây so với 8,566 giây.
- Giá 0,042 USD cho mỗi triệu token đầu vào, token đầu ra không tính phí.
- Trên các luồng công việc nhiều bước, hãng công bố nhanh hơn 193,6 lần và rẻ hơn 444,6 lần.
Đáng ghi nhận là chính TypeSafe cũng dè dặt với các con số này. Họ viết rằng đây là mức ở phía cao của lợi ích thực tế, rằng bộ đánh giá do chính đội của họ dựng nên có thể có thiên lệch, và rằng câu trả lời tham chiếu lấy trung bình từ mô hình của OpenAI và Anthropic nên cũng nghiêng về hai nhà đó.
Nói cách khác: chưa có đánh giá độc lập. Nhưng ngay cả khi chiết khấu mạnh, khoảng cách về độ trễ vẫn đáng chú ý với những việc chạy hàng nghìn lần mỗi ngày, nơi mỗi lần gọi mô hình mất vài giây là không dùng được.
Điều cần nói thẳng về "không ảo giác"
Tuyên bố gây chú ý nhất là Jev không thể ảo giác. Cần hiểu đúng: đầu ra luôn khớp với kiểu dữ liệu đã khai báo. The Register nhận xét thẳng rằng phép so sánh này không tương đương, vì đầu ra là dữ liệu có cấu trúc chứ không phải văn bản tự nhiên.
Thêm nữa, việc bảo đảm đầu ra khớp lược đồ không còn mới. Tài liệu của OpenAI về Structured Outputs nói rõ mô hình "luôn sinh phản hồi tuân theo JSON Schema bạn cung cấp", nhờ kỹ thuật ràng buộc ngay lúc giải mã. Khớp lược đồ là chuyện đã giải xong ở nhiều nơi.
Vậy cái mới thật sự của Jev nằm ở ba chỗ khác: độ trễ, chi phí, và xác suất được hiệu chỉnh. Và một điều chính TypeSafe cũng nói trên trang của họ: mô hình vẫn có thể sai. Khớp kiểu dữ liệu không có nghĩa là đúng.
Nguồn: OpenAI — Structured outputs · TypeSafe AI
Vì sao xác suất hiệu chỉnh mới là phần đáng giá
Trong một quy trình nghiệp vụ, câu hỏi khó không phải "mô hình đoán gì" mà "khi nào được phép tự làm, khi nào phải hỏi người". Một mô hình lúc nào cũng trả lời chắc nịch buộc bạn chọn giữa hai thái cực: tin hết, hoặc bắt người duyệt hết.
Nếu mô hình trả kèm một xác suất đáng tin, bạn có lựa chọn thứ ba: đặt ngưỡng. Trên ngưỡng thì hệ thống tự thực hiện; dưới ngưỡng thì chuyển thành việc cần người duyệt. Ngưỡng ấy là một tham số kinh doanh, điều chỉnh được theo mức rủi ro của từng loại quyết định.
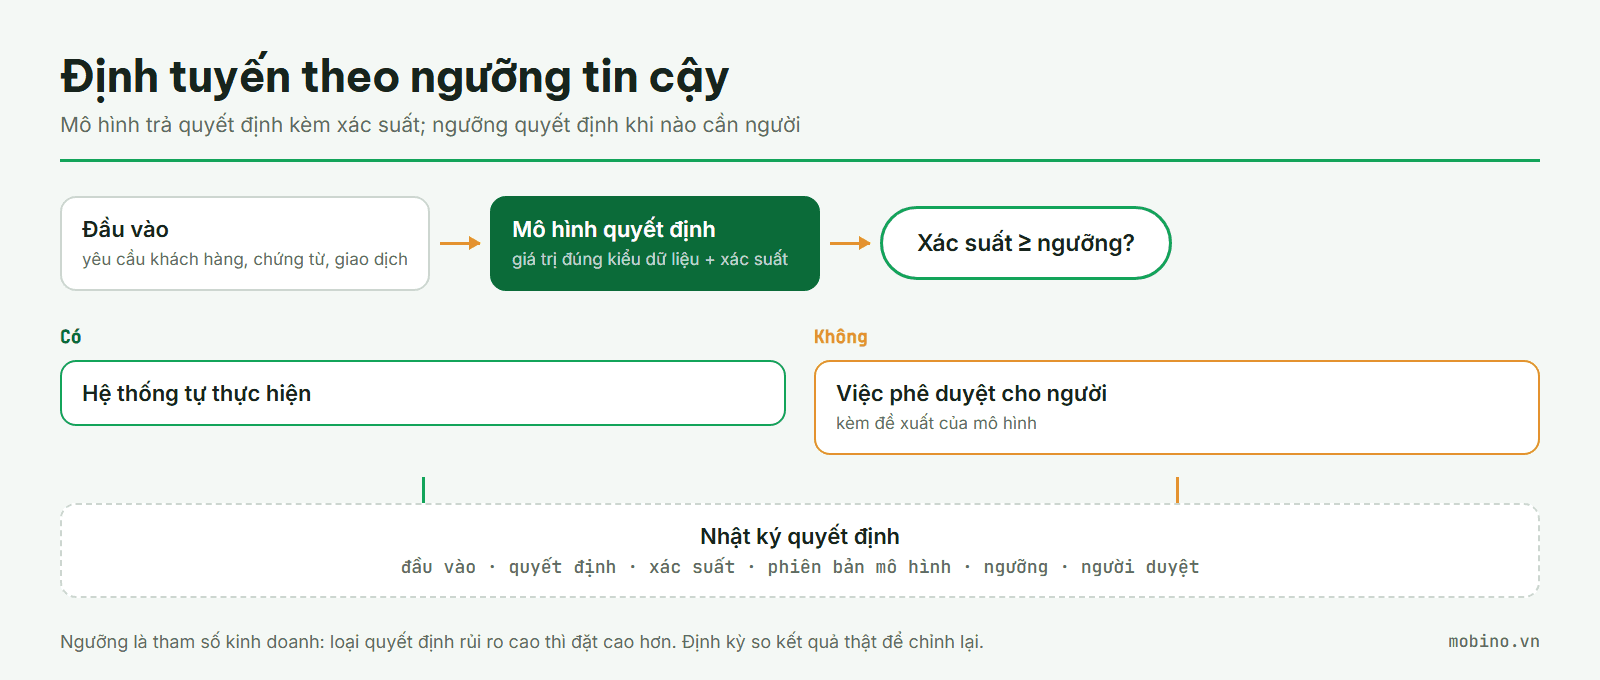
Trong thực tế, ngưỡng thường không chỉ có một mức. Một cách chia hay dùng:
- Trên 0,95: hệ thống tự xử lý, chỉ ghi nhật ký.
- Từ 0,70 đến 0,95: chạy thêm một bước kiểm tra tự động, ví dụ đối chiếu với dữ liệu gốc hoặc một quy tắc nghiệp vụ, rồi mới quyết định.
- Dưới 0,70: chuyển người duyệt, kèm đề xuất và lý do của mô hình.
Lưu ý rằng "đáng tin" ở đây có nghĩa kỹ thuật: trong số các lần mô hình nói chắc 80%, khoảng 80% phải đúng. Đó là thứ phải đo trên dữ liệu của chính bạn, không thể nhận từ trang giới thiệu.
Ghép vào ứng dụng doanh nghiệp thế nào
Với một ứng dụng xây trên nền tảng như Mendix, cách ghép khá thẳng:
- Microflow gọi dịch vụ quyết định qua REST, nhận về giá trị đúng kiểu dữ liệu và xác suất.
- So xác suất với ngưỡng của loại quyết định đó. Trên ngưỡng: đi tiếp. Dưới ngưỡng: tạo việc phê duyệt trong workflow, kèm đề xuất của mô hình để người duyệt không phải bắt đầu từ số không.
- Ghi vào nhật ký: đầu vào, quyết định, xác suất, phiên bản mô hình, ngưỡng đang áp dụng, và người duyệt nếu có. Đây là phần trả lời câu hỏi của kiểm toán viên sau này.
- Định kỳ so quyết định tự động với kết quả thực tế để chỉnh ngưỡng, thay vì đặt một lần rồi quên.
Cách này cũng là lý do chúng tôi hay nhắc rằng logic nghiệp vụ nên nằm ngoài công cụ của nhà cung cấp mô hình. Mô hình quyết định là một dịch vụ có thể thay; quy trình, ngưỡng và nhật ký thì nên thuộc về ứng dụng của bạn.
Mẫu phân tầng: mô hình quyết định đứng trước, LLM đứng sau
Phần này không phải tính năng của Jev, mà là cách ghép chúng tôi thấy hiệu quả. Jev chỉ nhận trạng thái và trả về một quyết định; việc chia tầng và chuyển tiếp là do ứng dụng của bạn làm.
Lấy một kênh chăm sóc khách hàng làm ví dụ. Mọi tin nhắn đến đều đi qua lớp quyết định trước. Lớp này trả về ý định kèm xác suất:
{
  "intent": "CHAO_HOI",
  "probability": 0.96
}- Chào hỏi, hỏi trạng thái đơn hàng, đổi địa chỉ giao: ứng dụng trả lời bằng mẫu câu hoặc truy vấn thẳng cơ sở dữ liệu, không cần gọi mô hình ngôn ngữ lớn.
- Khiếu nại phức tạp, hỏi điều khoản hợp đồng: chuyển cho LLM, kèm ngữ cảnh đã được lớp trước chuẩn hóa — loại yêu cầu, mã khách hàng, mã đơn.
- Không phân loại được chắc chắn: mặc định đẩy lên tầng sau, chứ không tự trả lời.
Quy tắc cuối quan trọng hơn vẻ ngoài của nó. Rủi ro lớn nhất của mẫu phân tầng là một câu hỏi khó bị gán nhầm vào nhánh trả lời nhanh, và khách nhận một câu mẫu vô nghĩa. Đặt ngưỡng sao cho khi mô hình lưỡng lự thì hệ thống chọn đường đắt hơn nhưng an toàn hơn.
Về hiệu quả, lợi ích đến từ việc phần lớn yêu cầu không còn chạm tới mô hình lớn: chi phí giảm và độ trễ giảm cho đúng nhóm yêu cầu đó. Tỷ lệ cụ thể phụ thuộc hoàn toàn vào phân bố yêu cầu của bạn, nên hãy đo trên dữ liệu thật thay vì tin một con số chung.
Vì sao gọi là System One
Tên lớp mô hình lấy từ cách phân đôi quen thuộc của Daniel Kahneman: System 1 là suy nghĩ nhanh và trực giác, System 2 là suy luận chậm và có chủ đích. Jev nhắm vào vế thứ nhất: rất nhiều quyết định nhỏ, nhanh, lặp lại, thay vì một chuỗi suy luận dài.
Còn tên Jev lấy từ William Stanley Jevons. Hãng dẫn lại nghịch lý mang tên ông: động cơ hơi nước hiệu quả hơn không làm giảm lượng than tiêu thụ mà khiến nhu cầu tăng lên. Họ kỳ vọng trí tuệ máy đi theo cùng một đường: khi mỗi quyết định rẻ đi hàng trăm lần, phần mềm sẽ dùng nhiều quyết định hơn chứ không phải tiết kiệm chi phí.
Giới hạn cần biết trước khi thử
- Jev đang ở giai đoạn truy cập sớm, phải đăng ký danh sách chờ.
- Mô hình không sinh văn bản, nên không thay được LLM cho việc soạn thảo, tóm tắt hay trả lời khách hàng bằng lời.
- Theo AI News, số lựa chọn rời rạc cho một quyết định giới hạn ở mức 255, nên các bài toán phân loại có hàng nghìn nhãn chưa hợp.
- Mọi con số hiệu năng hiện có đều từ nhà cung cấp. Trước khi đưa vào quy trình thật, nên đo trên tập dữ liệu của mình cả độ chính xác lẫn độ hiệu chỉnh của xác suất.
Với doanh nghiệp Việt Nam
Chưa cần vội đổi hạ tầng. Nhưng hướng đi thì đáng theo dõi: sau nhiều năm mọi mô hình đều nói chuyện với người, bắt đầu có lớp mô hình sinh ra để phần mềm đọc. Những việc lặp lại hàng nghìn lần mỗi ngày — phân loại yêu cầu, định tuyến hồ sơ, gắn nhãn giao dịch, trích trường từ chứng từ — là nơi lớp mô hình này hợp nhất.
Điều đáng suy nghĩ nhất ở bài công bố này không phải Jev nhanh hơn bao nhiêu lần, vì đó vẫn là benchmark của chính họ. Đáng suy nghĩ là cách chia vai: LLM lo phần suy luận phức tạp; một mô hình kiểu System One lo hàng nghìn quyết định nhỏ có lược đồ rõ ràng; còn workflow và mã nguồn xác định vẫn giữ quyền kiểm soát toàn bộ.
Đó là hướng đặt AI thành một lớp ra quyết định bên trong quy trình, thay vì biến cả quy trình thành một agent tự do. Với hệ thống phê duyệt, mô hình có thể trả về loại yêu cầu, mức rủi ro, tuyến duyệt đề xuất và dấu hiệu bất thường, kèm xác suất cho từng phần — còn ai được duyệt và duyệt theo thứ tự nào thì vẫn do quy trình quyết định.
Và dù chọn mô hình nào, phần quyết định giá trị vẫn là thứ bao quanh nó: ngưỡng tin cậy, điểm dừng cho con người, nhật ký truy vết. Đó là phần không nhà cung cấp nào làm thay được. Nếu bạn đang xây những luồng như vậy, xem thêm tại trang tự động hóa thông minh & AI.